
07.10.2026 · Signal Titans Editorial
Más allá de la búsqueda por fuerza bruta: cómo las redes neuronales profundas superaron el juego invencible para los ordenadores
Cómo AlphaGo y AlphaZero de DeepMind impulsaron la IA desde reglas manuales hacia el aprendizaje por refuerzo profundo tras dominar el milenario Go.
El milenario juego del Go, originado en Asia Oriental antes del siglo IV a. C., se disputa sobre un tablero con una cuadrícula de 19 por 19 intersecciones de líneas. Los jugadores se turnan para colocar piedras negras y blancas con el fin de rodear territorio, generando patrones estratégicos de enorme complejidad. A diferencia del ajedrez, que los sistemas de computación simbólica lograron dominar mediante búsquedas en árbol por fuerza bruta, el Go planteaba una escala inalcanzable para el hardware computacional clásico. Con un factor de ramificación de 361 opciones en cada turno, el tablero ofrece aproximadamente 10 a la potencia de 170 configuraciones válidas, una cifra que supera ampliamente la cantidad total de átomos presentes en el universo observable. Los programas heurísticos tradicionales eran incapaces de navegar semejante complejidad combinatoria.
De las reglas programadas a mano a los sistemas de aprendizaje
En sus inicios, la inteligencia artificial simbólica requería que ingenieros humanos programaran manualmente las reglas del dominio y las funciones de evaluación de búsqueda. En 1959, Arthur Samuel acuñó el término aprendizaje automático mientras exhibía una aplicación de damas ejecutada en un ordenador central IBM 7090, demostrando que los ordenadores podían aprender a partir de partidas registradas. Sin embargo, los enfoques simbólicos fracasaban ante tareas intuitivas o de procesamiento visual complejo. Durante la década de 1980, científicos cognitivos de la Universidad de California en San Diego —entre ellos Geoffrey Hinton— aplicaron algoritmos de retropropagación a redes neuronales profundas, lo que permitió procesar patrones a través de múltiples capas. El cambio de paradigma se consolidó de manera decisiva en 2012, cuando Alex Krizhevsky empleó unidades de procesamiento gráfico para entrenar AlexNet, dominando la competición de reconocimiento visual ImageNet e impulsando con fuerza el movimiento general del aprendizaje automático.
La arquitectura de política y valor
Para dominar el Go sin recurrir a reglas diseñadas a mano, los informáticos de Google DeepMind combinaron algoritmos de búsqueda probabilística con redes neuronales profundas. AlphaGo integró la búsqueda en árbol de Montecarlo con dos arquitecturas de red neuronal distintas: una red de política y una red de valor. La red de política analizaba las posiciones del tablero para seleccionar movimientos candidatos con alta probabilidad de éxito, reduciendo de manera drástica el abrumador factor de ramificación de 361 opciones. Por su parte, la red de valor evaluaba la disposición del tablero para estimar la probabilidad general de victoria desde cualquier posición. En una fase inicial, DeepMind entrenó ambas redes utilizando miles de partidas jugadas por expertos humanos, para luego permitir que AlphaGo disputara encuentros contra sí mismo, perfeccionando su precisión estratégica mediante aprendizaje por refuerzo.
El movimiento 37 y la frontera del refuerzo
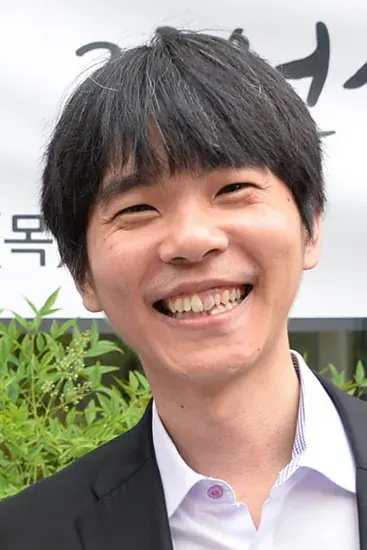
En marzo de 2016, AlphaGo se enfrentó al gran maestro surcoreano Lee Sedol y se impuso en la serie de cinco partidas por 4-1. Durante la segunda partida, AlphaGo ejecutó el movimiento 37 en la quinta línea, una jugada que desconcertó a los comentaristas, quienes en un principio la consideraron un error, pero que terminó asegurando la victoria y transformando de forma radical el juego humano moderno. Tras este hito, DeepMind desarrolló AlphaZero, un sistema que eliminó por completo los datos de entrenamiento procedentes de humanos. Operando exclusivamente mediante aprendizaje por refuerzo puro, AlphaZero alcanzó un nivel de maestría equivalente al de un gran maestro en Go, ajedrez y shogi. Al jugar al ajedrez, AlphaZero evaluaba tan solo 60 000 posiciones por segundo, superando con claridad al programa tradicional líder, Stockfish, que calculaba 60 millones de posiciones por segundo.
Más allá del tablero de juego
El abandono de las reglas humanas preprogramadas demostró que las redes neuronales profundas podían descubrir estrategias novedosas y sumamente eficaces de forma independiente. Al probar que el aprendizaje automático era capaz de navegar por espacios de decisión de alta dimensión sin guía humana, estos algoritmos se extendieron más allá de los juegos de mesa. Posteriormente, DeepMind adaptó estas estructuras de redes neuronales para abordar problemas físicos complejos, lo que condujo de forma directa al desarrollo de herramientas como AlphaFold, orientada a predecir estructuras tridimensionales de proteínas en la investigación biológica.
Imagen de portada: ilustración generada con IA; no es una fotografía documental.
 SIGNAL TITANS
