
07.10.2026 · Signal Titans Editorial
Jenseits der Brute-Force-Suche: Wie tiefe neuronale Netze das unlösbare Brettspiel meisterten
Wie AlphaGo und AlphaZero von DeepMind die KI von manuellen Regeln zu tiefem Bestärkendem Lernen führten und das antike Go-Spiel meisterten.
Das antike Spiel Go, das auf einem Gitter von 19 mal 19 Linienkreuzungen gespielt wird, entstand vor dem 4. Jahrhundert v. Chr. in Ostasien. Abwechselnd platzieren die Spieler schwarze und weiße Steine, um Territorium zu umzingeln und komplexe strategische Muster zu erschaffen. Im Gegensatz zum Schachspiel, das symbolische Computersysteme schließlich mithilfe von Brute-Force-Baumsuchen bewältigten, stellte Go eine Dimension dar, die sich klassischer Hardware entzog. Bei einem Verzweigungsfaktor von 361 Wahlmöglichkeiten pro Zug erlaubt das Spielbrett etwa 10 hoch 170 gültige Konfigurationen – eine Zahl, die die Gesamtzahl aller Atome im beobachtbaren Universum bei Weitem übersteigt. Traditionelle heuristische Programme waren nicht in der Lage, diese kombinatorische Komplexität zu bewältigen.
Von handcodierten Regeln zu lernenden Systemen
Frühe symbolische künstliche Intelligenz erforderte von menschlichen Entwicklern das manuelle Programmieren von Domänenregeln und Suchbewertungsfunktionen. Im Jahr 1959 prägte Arthur Samuel den Begriff Machine Learning (Maschinelles Lernen), als er eine Dame-Software auf einem IBM-7090-Großrechner demonstrierte und zeigte, dass Computer aus aufgezeichneten Spielverläufen lernen können. Dennoch versagten symbolische Ansätze bei komplexen visuellen oder intuitiven Aufgaben. In den 1980er-Jahren wandten Kognitionswissenschaftler an der University of California, San Diego – darunter Geoffrey Hinton – Backpropagation-Algorithmen auf tiefe neuronale Netze an, was eine vielschichtige Musterverarbeitung ermöglichte. Der entscheidende Paradigmenwechsel erfolgte 2012, als Alex Krizhevsky Grafikprozessoren nutzte, um AlexNet zu trainieren. Damit dominierte er den ImageNet-Wettbewerb für visuelle Erkennung und beschleunigte die breitere Machine-Learning-Bewegung.
Die Architektur von Policy und Value
Um Go ohne manuell erstellte Regeln zu meistern, kombinierten Informatiker bei Google DeepMind stochastische Suchalgorithmen mit tiefen neuronalen Netzen. AlphaGo verknüpfte die Monte-Carlo-Baumsuche mit zwei unterschiedlichen Architekturen neuronaler Netze: einem Policy-Netzwerk und einem Value-Netzwerk. Das Policy-Netzwerk analysierte Brettpositionen, um vielversprechende Zugkandidaten auszuwählen, was den Verzweigungsfaktor von 361 drastisch reduzierte. Das Value-Netzwerk bewertete unterdessen die Brettstellung, um die allgemeine Gewinnwahrscheinlichkeit aus jeder Position abzuschätzen. DeepMind trainierte beide Netzwerke zunächst mit Tausenden Partien menschlicher Experten, bevor AlphaGo in Selbstspiel-Matches gegen sich selbst antrat und seine strategische Präzision durch Bestärkendes Lernen verfeinerte.
Zug 37 und die Grenzen des Bestärkenden Lernens
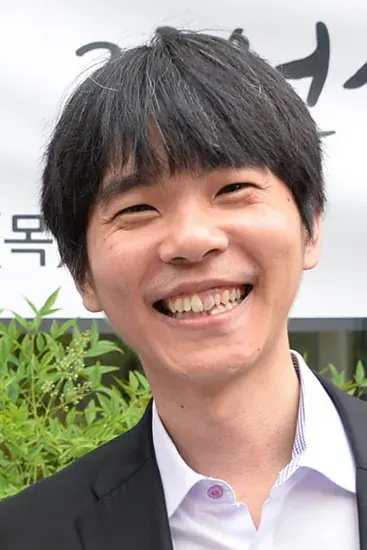
Im März 2016 trat AlphaGo gegen den südkoreanischen Großmeister Lee Sedol an und gewann die Serie aus fünf Spielen mit 4:1. In der zweiten Partie führte AlphaGo Zug 37 in der fünften Reihe aus – einen Zug, der Kommentatoren überraschte, die ihn zunächst für einen Fehler hielten, der jedoch den Sieg sicherte und das moderne menschliche Spiel grundlegend veränderte. Nach diesem Meilenstein entwickelte DeepMind AlphaZero, das vollständig auf menschliche Trainingsdaten verzichtete. Basierend auf reinem Bestärkendem Lernen erreichte AlphaZero Großmeister-Niveau in Go, Schach und Shogi. Beim Schachspiel bewertete AlphaZero lediglich 60.000 Positionen pro Sekunde und übertraf damit das führende traditionelle Programm Stockfish, das 60 Millionen Positionen pro Sekunde berechnete, bei Weitem.
Über das Spielbrett hinaus
Die Abkehr von vorprogrammierten menschlichen Regeln bewies, dass tiefe neuronale Netze eigenständig neuartige, hochwirksame Strategien entdecken können. Indem diese Algorithmen zeigten, dass maschinelles Lernen hochdimensionale Entscheidungsräume ohne menschliche Anleitung navigieren kann, gingen sie weit über Brettspiele hinaus. DeepMind passte diese neuronalen Netzstrukturen anschließend an, um komplexe physikalische Probleme zu lösen, was direkt zu Werkzeugen wie AlphaFold für die Vorhersage dreidimensionaler Proteinstrukturen in der biologischen Forschung führte.
Titelbild: KI-generierte Illustration; kein Dokumentarfoto.
 SIGNAL TITANS
