
06.10.2026 · Signal Titans Editorial
Brewster Kahle viu a Web desaparecer. Então construiu uma memória para ela.
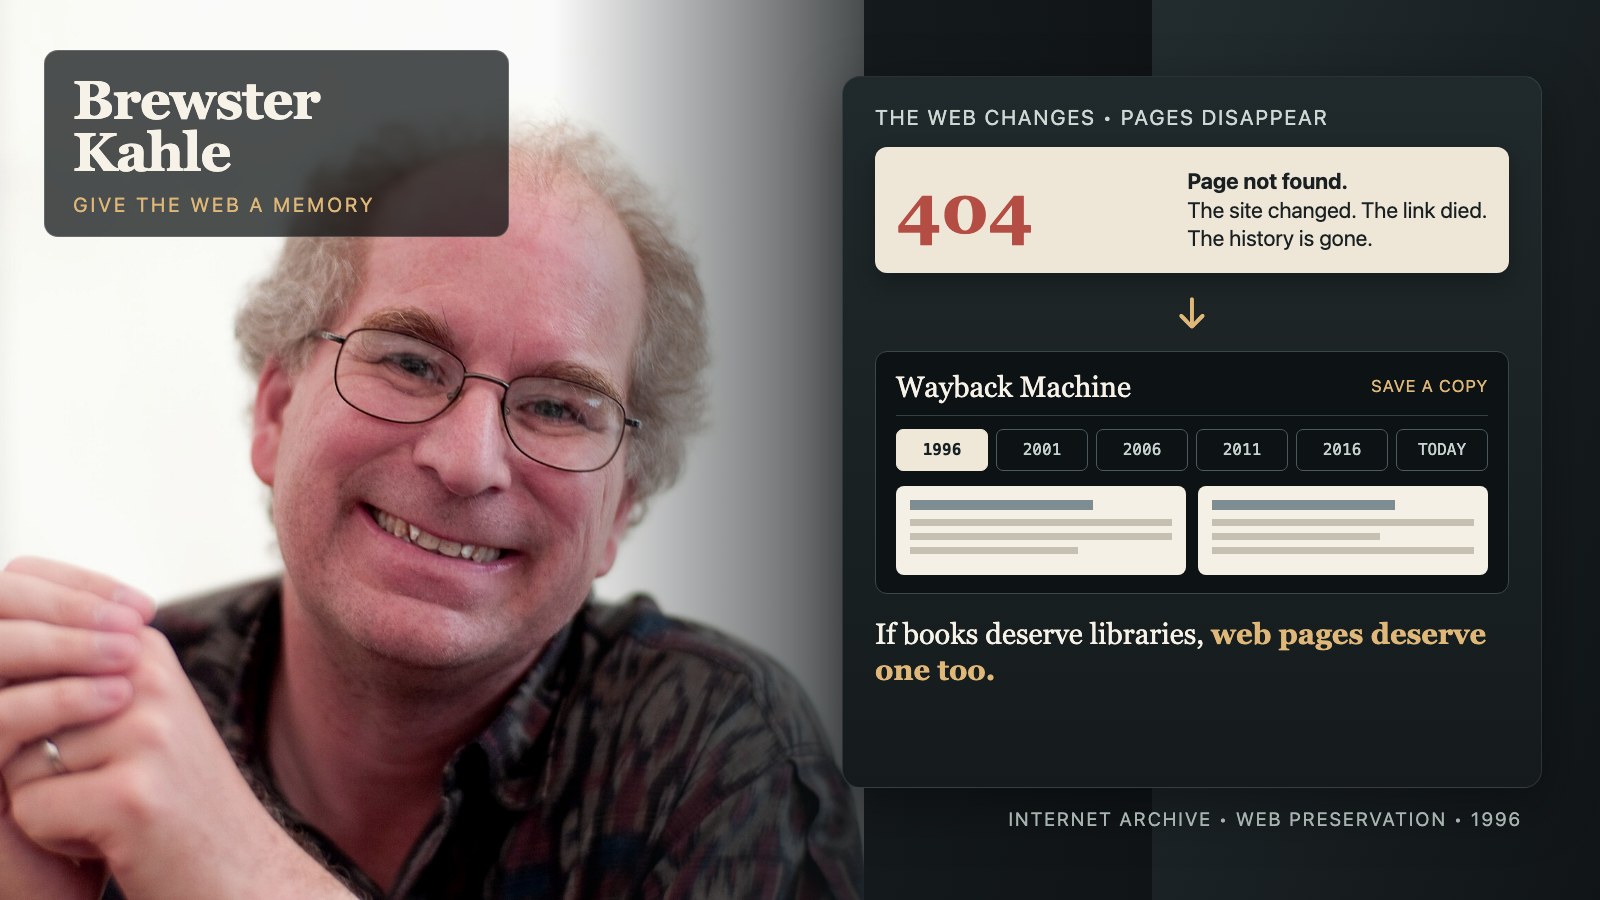
A Web foi construída para publicar rapidamente.
Brewster Kahle se preocupou com o que aconteceria quando ela desaparecesse com a mesma rapidez.
Páginas mudam.
Sites fecham.
Links morrem.
Um documento pode existir hoje e desaparecer amanhã sem deixar registro histórico.
Então, em 1996, Kahle fundou o Internet Archive.
A ideia hoje parece quase óbvia:
Se livros merecem bibliotecas, a Web também merece uma.
Kahle perseguia o “acesso universal ao conhecimento” havia anos
O Internet Archive não surgiu do nada.
Kahle estudou ciência da computação e engenharia no MIT e depois trabalhou na Thinking Machines com computadores massivamente paralelos.
Interessou-se por sistemas capazes de buscar grandes coleções de informação.
Em 1989, ajudou a criar WAIS — Wide Area Information Server — um sistema distribuído de publicação e busca.
Depois fundou a WAIS Inc., comprada pela AOL.
Em meados dos anos 1990, Kahle já pensava em informação na escala da Internet.
Mas busca resolve apenas uma pergunta:
Como encontrar o que existe agora?
Arquivamento faz outra, mais difícil:
Como encontrar o que existia antes?
A Web não tinha memória por padrão
Publicação física deixa artefatos.
Um jornal pode ficar numa biblioteca.
Um livro pode sobreviver à editora.
Uma carta pode permanecer cem anos numa caixa.
Páginas web são diferentes.
O editor controla a cópia viva.
Mude o arquivo e a versão anterior desaparece.
Desligue o servidor e a página some.
A menos que alguém tenha feito uma cópia.
Kahle via a Web se tornar parte da cultura, negócios e política enquanto ainda se comportava como dado temporário.
Essa diferença virou o problema.
Em 1996, ele começou a capturar a Web
Kahle fundou o Internet Archive sem fins lucrativos em 1996.
No mesmo ano, cofundou a Alexa Internet.
A infraestrutura de crawling da Alexa ajudava a coletar informação sobre a Web.
As cópias das páginas rastreadas também podiam ser preservadas.
Em vez de tratar páginas antigas como sobra inútil do crawler, o Archive as tratou como história.
A escala era assustadora.
A Web mudava o tempo todo.
Não havia uma versão final para coletar.
Arquivar significava tirar snapshots repetidamente de um alvo em movimento.
O arquivo existia antes de o público conseguir navegar por ele facilmente
Durante vários anos, o Internet Archive coletou material sem a interface que hoje associamos ao projeto.
Em 2001, a Wayback Machine ficou disponível ao público.
A interação era incomum.
Digite uma URL.
Escolha uma data.
Veja uma versão antiga.
De repente a Web tinha um passado visível.
Um site que não existia mais podia, às vezes, ser visitado novamente.
Um documento deletado podia reaparecer.
Uma era inteira do design podia ser navegada em vez de apenas lembrada.
Por que arquivar algo que parece banal?
Uma página sem importância hoje pode se tornar valiosa depois.
Um manual antigo.
Uma página de campanha política.
Um anúncio de produto.
Um post de fórum.
Termos de serviço antigos.
Um site pessoal de uma comunidade desaparecida.
Historiadores raramente sabem de antemão quais objetos cotidianos virarão evidência.
Bibliotecas preservam amplamente porque a importância costuma aparecer só em retrospecto.
Kahle aplicou essa lógica à Internet.
A Web muda mais rápido que a memória humana
A capacidade de atualizar instantaneamente é uma das forças da Web.
Mas mudança tem custo.
Se cada nova versão destrói a anterior, perdemos a capacidade de inspecionar o que antes era público.
Arquivos transformam mudança de destruição em história.
Preservação digital nunca termina
Arquivar um livro impresso é difícil, mas finito.
Arquivar a Web é contínuo.
Novas páginas aparecem a cada segundo.
As antigas mudam.
Sites viram aplicações dinâmicas.
Conteúdo vai para trás de APIs, logins e scripts.
Vídeo, software e sistemas interativos complicam ainda mais a preservação.
O projeto de Kahle se parece menos com uma biblioteca concluída e mais com uma corrida permanente contra o desaparecimento.
A Wayback Machine mudou o significado de um 404
Sem arquivo, um link morto é o fim.
O documento se foi.
Com arquivo, vira uma pergunta:
Isso foi capturado antes de desaparecer?
Essa pequena mudança permite a pesquisadores, jornalistas, desenvolvedores, advogados e usuários comparar a Web ao longo do tempo.
A página não precisa viver para sempre.
Alguém só precisa ter salvo uma cópia.
Existe uma lição de produto dentro da preservação
A maioria dos softwares é desenhada em torno do estado atual.
Como está a conta agora?
Qual é o preço atual?
O que a página diz hoje?
Mas alguns produtos ganham muito valor quando preservam história.
Version control.
Audit logs.
Event sourcing.
Histórico de documentos.
Backups.
Data lineage.
O estado atual diz o que é verdade agora.
A história diz como você chegou lá.
Internet Archive lembra que apagar também é uma decisão de design
Sistemas digitais tornam sobrescrever muito fácil.
Essa conveniência pode fazer história desaparecer sem intenção.
O trabalho de Kahle faz uma pergunta que todo sistema de informação deveria considerar:
O que merece sobreviver depois que a versão atual muda?
Nem tudo precisa de armazenamento permanente.
Mas se algo importa para cultura, lei, ciência, negócios ou memória, alguém precisa decidir que preservação faz parte do produto.
A Web não veio com essa função por padrão.
Brewster Kahle decidiu construí-la.
Que informação no seu produto ficaria muito mais valiosa se usuários pudessem ver não só o que ela diz hoje, mas o que dizia há um ano?
Fontes
- Computer History Museum — Brewster Kahle, perfil Fellow 2026
- Computer History Museum — Brewster Kahle, Founder and Digital Librarian
- Internet Hall of Fame — Brewster Kahle
- Internet Hall of Fame — Brewster Kahle: Internet’s Historian
- Internet Hall of Fame — The Wayback Machine Turns Twenty
- Retrato da imagem destacada — Brewster Kahle no Foo Camp 2009, foto de Joi Ito, CC BY 2.0 via Wikimedia Commons. A composição editorial é original.
 SIGNAL TITANS
